El posicionamiento en Google, considerando la transformación generada por la inteligencia artificial (IA), no es un tema de suerte. El motor de búsqueda no es una caja negra, sino un sistema automatizado que opera en tres etapas principales: rastreo, indexación y publicación de resultados.
Las marcas deben comprender cada una de estas etapas, porque esto marca la diferencia entre publicar contenido que nunca se descubre y avanzar a pasos de hormiga en la construcción de una presencia digital sólida. Por triste que parezca, los problemas de visibilidad no se resuelven solo con una mejor escritura, sino con un diagnóstico SEO técnico que muestre en qué etapa del proceso tu sitio queda “atascado”.
Google no garantiza que rastreará, indexará y mostrará tu página en los resultados de búsqueda, incluso si cumples estrictamente con todas sus directrices. Esta es una verdad que las marcas deben aceptar desde el principio. Sin embargo, las empresas pueden trabajar de manera eficiente para asegurar una calidad elevada en las señales SEO que emite el sitio web en cada etapa.
¿Qué es el rastreo y cómo descubre Google nuevas páginas?
La primera etapa del proceso es el rastreo de Google o crawl. Google descarga el texto, las imágenes y los videos de las páginas que encuentra en la web mediante programas automatizados llamados crawlers. Seguramente has escuchado hablar de Googlebot, el más conocido de todos ellos.
No existe un registro central de todas las páginas web, ya que la propia dinámica del buscador requiere encontrar páginas nuevas y actualizadas para agregarlas a su lista de páginas conocidas. Esta etapa es conocida como “descubrimiento de URLs” y se lleva a cabo por tres vías principales:
- Páginas ya conocidas: Google las ha visitado antes y las mantiene en su lista.
- Enlaces desde páginas ya conocidas: Google extrae un enlace de una página que ya conoce, por ejemplo, una página de categoría que enlaza a una nueva entrada de blog.
- Sitemaps: listas de páginas que envías para ayudar a Google en el proceso de rastreo.
Cómo Googlebot decide qué sitios rastrear y con qué frecuencia
El crawler Googlebot no rastrea todas las URLs que descubre ni lo hace con la misma frecuencia en todos los sitios. Mediante un proceso algorítmico, determina qué sitios rastrear, con qué frecuencia y cuántas páginas obtener de cada uno. En esta fase, el concepto clave es la cuota de rastreo: el tiempo y los recursos que Google dedica a rastrear el sitio. Esta cuota está determinada por dos elementos principales:
- Límite de capacidad de rastreo. Googlebot trata de rastrear el sitio web sin sobrecargar servidores, por lo que calcula el número de conexiones paralelas que puede usar de forma simultánea y el retraso entre búsquedas. Si los tiempos de respuesta del sitio son altos o lentos, Googlebot hará menos rastreos.
- Demanda de rastreo. Google gasta el tiempo que considera necesario según el tamaño del sitio, la frecuencia de actualización, la calidad de las páginas y la relevancia del sitio web comparado con otros. Los factores más importantes son el inventario percibido, si cuentas con URLs duplicadas o que no quieres que se rastreen y la popularidad de las URLs.
Qué papel juegan los enlaces internos y los sitemaps en el descubrimiento de URLs
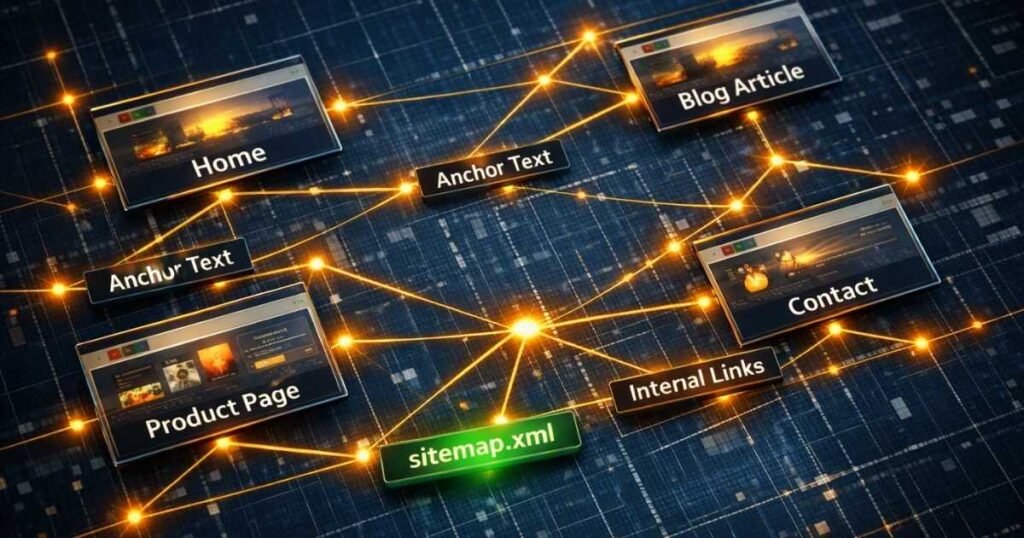
Los enlaces internos son la principal vía de descubrimiento. Googlebot navega entre URLs rastreando y analizando enlaces, sitemaps y redirecciones. Trata cada URL como si fuera la primera y única que ve en tu sitio, por lo que necesita llegar a todas las páginas importantes mediante una estrategia de enlazado interno.
Esto implica que:
- Todas las páginas deben ser alcanzables mediante enlaces rastreables desde otras páginas que Google ya conoce.
- El texto ancla (anchor text) debe ser relevante respecto al contenido de la página de destino.
- Para las imágenes, el atributo alt cumple una función similar.
Los sitemaps son la segunda vía de descubrimiento y cumplen un rol complementario. Si bien Google no limita el rastreo a las páginas que aparecen en esa lista, sí les concederá mayor prioridad. Esto es muy importante para sitios con contenido que cambia de forma rápida y con páginas que podrían no descubrirse a través de enlaces.
Un sitemap construido de forma adecuada incluye solo las URLs canónicas, además de estar referenciado en robots.txt y actualizarse cuando haya cambios significativos en el contenido. Subir un sitemap en la Search Console no garantiza el rastreo inmediato.
Cómo funciona la indexación en Google y qué analiza dentro de una página
Después de rastrear una página, Google inicia la indexación. Durante esta etapa, analiza los archivos de texto, las imágenes y los videos de la página, y almacena la información en el índice de Google, una base de datos de gran tamaño. El proceso incluye el análisis del contenido textual, los encabezados, los metadatos y la estructura de la página. Además, Google determina su relevancia y su estado canónico.
Ojo aquí: No todo lo que se rastrea se indexa. Cada página es evaluada después del rastreo para determinar si entra o no en el índice de Google. Los factores que determinan si va o no son la calidad del contenido, la duplicación y la utilidad para el usuario.
Cómo interpreta Google el contenido, las imágenes y JavaScript
Durante la carga de la página, Google puede ejecutar JavaScript, pero analiza el HTML renderizado al final del proceso. Esto significa que las imágenes cargadas exclusivamente mediante eventos de clic o interacciones de JavaScript pueden no detectarse, ya que Googlebot no hace clic en esos elementos.
La indexación correcta de las imágenes requiere que:
- Se encuentren en etiquetas <img> estándar con atributos src claros.
- Utilicen URLs estables y se carguen de manera predecible.
- Se permita el acceso de Googlebot a los archivos de imagen, JavaScript y CSS utilizados por la página.
Un error frecuente es bloquear el rastreo de archivos JavaScript o CSS mediante robots.txt. Esto impide que Google renderice la página de manera correcta y pueda hacer que contenido esencial no sea visible para el índice.
Qué factores pueden impedir que una página sea indexada
Los motivos de no indexación de páginas rastreadas son distintos. Por ello, es importante que los profesionales sean capaces de identificar en dónde se detiene el proceso. Los bloqueadores comunes son:
| Etapa | Causa típica | Evidencia a revisar |
| Descubrimiento | La URL no está enlazada ni en el sitemap | Enlaces internos, sitemap, página de referencia |
| Acceso | robots.txt bloquea el rastreo, autenticación requerida | robots.txt, logs del servidor |
| Respuesta | Error 404, 5xx, redirección incorrecta, soft 404 | Código de estado HTTP |
| Renderizado | El contenido útil no aparece en el HTML renderizado | URL Inspection, HTML renderizado |
| Directiva | Etiqueta noindex o cabecera X-Robots-Tag | Meta robots, cabeceras HTTP |
| Canonical | Google elige una URL diferente como canónica | Canonical declarada vs. seleccionada por Google |
| Selección | Contenido duplicado, poco valor, baja utilidad | Duplicación, intención de búsqueda, importancia interna |
La canonicalización suele ser una de las razones ocultas por las que una página aparentemente saludable no se indexa como tal. Search Console puede mostrar “Duplicada, Google eligió una canónica diferente”, cuando Google considera que otra URL representa mejor el mismo contenido.
Cómo decide Google qué páginas mostrar primero en los resultados
La tercera etapa del proceso es la publicación de resultados. Cuando un usuario realiza una consulta, el sistema devuelve la información más relevante considerando factores como la ubicación, el dispositivo y la intención de búsqueda, entre muchos otros.
Qué señales de relevancia y calidad influyen en el ranking de Google
Los sistemas de ranking de Google analizan y evalúan una amplia variedad de señales. No existe una única señal de “experiencia de página” que determine la posición, sino un conjunto de factores que trabajan de forma simultánea.
Entre ellas, sobresalen:
- Tiempo de permanencia
- Profundidad del scroll
- Usuarios recurrentes
- Bajo pogo-sticking (cuando el usuario vuelve a la página de resultados porque el contenido no satisfizo su consulta).
Las Core Web Vitals son el suelo, no el techo, de la evaluación de calidad.
Cómo afectan la experiencia del usuario y la velocidad al posicionamiento SEO
Las Core Web Vitals son un conjunto de métricas que evalúan la experiencia del usuario en una página web según su rendimiento de carga, capacidad de respuesta y estabilidad visual. Google utiliza estas señales en sus sistemas de posicionamiento, por lo que se recomienda alcanzar valores favorables para mejorar la experiencia en la Búsqueda.
Las tres métricas principales son:
- LCP (Largest Contentful Paint): Mide la velocidad con que aparece el contenido significativo. El umbral recomendado es inferior a 2.5 segundos.
- INP (Interaction to Next Paint): Mide la capacidad de respuesta de la página durante la interacción.
- CLS (Cumulative Layout Shift): mide la estabilidad visual. El umbral recomendado es inferior a 0.1.
Una evaluación positiva en las Core Web Vitals no garantiza el posicionamiento en los primeros lugares. Otros aspectos que debes considerar son que las páginas se sirvan de forma segura mediante el protocolo HTTPS, que el contenido se muestre correctamente en dispositivos móviles y que se eviten tanto los anuncios que distraen del contenido principal como los intersticiales intrusivos.
Cómo interactúan el rastreo, la indexación y el ranking para definir la visibilidad
Las tres etapas son esenciales para el posicionamiento en Google. Rastreo, indexación y ranking forman un proceso en el que el fallo de una fase vuelve inútil el trabajo de las siguientes. Si Google no rastrea tu página, no tiene nada que indexar; si no la indexa, no puede posicionarla. Y si la rastrea, pero no la indexa, el esfuerzo dedicado a la calidad del contenido y los enlaces resulta irrelevante para la visibilidad en la búsqueda.
Por qué no todas las páginas rastreadas por Google se indexan
Existen muchos problemas que pueden hacer que tu página rastreada jamás llegue a indexarse. Este tipo de estancamiento ocurre cuando:
- Contenido de baja calidad o delgado: páginas que no aportan valor diferencial real.
- Duplicación: múltiples URLs con contenido idéntico o extremadamente similar.
- Selección canónica: Google determina que otra URL representa mejor el mismo contenido.
- Falta de demanda de búsqueda: el contenido no responde a ninguna consulta real de los usuarios.
Cómo optimizar cada etapa para mejorar la presencia en Google
Para mejorar el rastreo de Google
- Mantén un sitemap actualizado que solo incluya las URLs canónicas.
- Asegúrate de que todas las páginas importantes sean alcanzables mediante enlaces internos rastreables.
- Monitorea la cobertura del índice de manera regular.
Para mejorar la indexación en Google
- Verifica que las páginas importantes no estén bloqueadas por robots.txt ni por etiquetas no index.
- Mantén una canonicalización coherente para consolidar las señales en la URL preferida.
- Asegúrate de que el contenido útil esté presente en el HTML renderizado, no solo inyectado dinámicamente por JavaScript.
Para mejorar el ranking de Google
- Construye contenido que satisfaga la intención de búsqueda de forma más completa que los competidores
- Optimiza Core Web Vitals
- Garantizar seguridad HTTPS
- Aplica principios de usabilidad móvil
- Ausencia de intersticiales intrusivos
- Aplica diseño que facilite distinguir contenido principal y secundario
La regla final es simple: si no entiendes bien el proceso de rastreo, indexación y publicación, será difícil diagnosticar problemas o anticipar el comportamiento de la Búsqueda en tu sitio.